
單一 Agent 在同一個 Context 裡規劃、呼叫工具並整理結果。任務變複雜後,會遇到三個問題:
這三個問題都出在所有事情共用同一個 Context、同一組工具與同一份權限。Multi-Agent 把工作拆給多個 Agent,各自擁有獨立的 Context、工具集與行為指令:讀大量資料的子任務交給獨立 Context 的 Agent,只回傳摘要;每個 Agent 只配備自己領域的工具;處理不可信任輸入的 Agent 與握有高權限工具的 Agent 分開,兩者以約定好的格式交接結果。
接著來看 Multi-Agent 如何解決前面的問題。任務遇到下列情況時,切分出獨立的 Sub-Agent 能帶來實質效益:
大型語言模型的 Context Window 有限,且隨著輸入長度膨脹,模型的注意力與推理品質會逐步下降。當某個子任務需要翻閱大量資料,而這些原始資料對主任務並不重要時,就會造成「上下文污染(Context Pollution)」。
Log_Agent。它在獨立的 Context 內翻閱上萬行日誌,提煉出 100 Tokens 的結構化摘要(如 { "error_signature": "NullPointerException in Gateway", "count": 820 })回傳給主 Agent,保持主 Context 的精簡與專注。不同任務往往需要完全不同的工具集、行為模式或安全權限:
Multi-Agent 的協作架構常見有三種形態:固定順序交接的管線模式(Pipeline)、自由對話的去中心化模式(Peer-to-Peer / Swarms),以及由中心調度的協調者—子代理模式(Orchestrator-Subagent)。
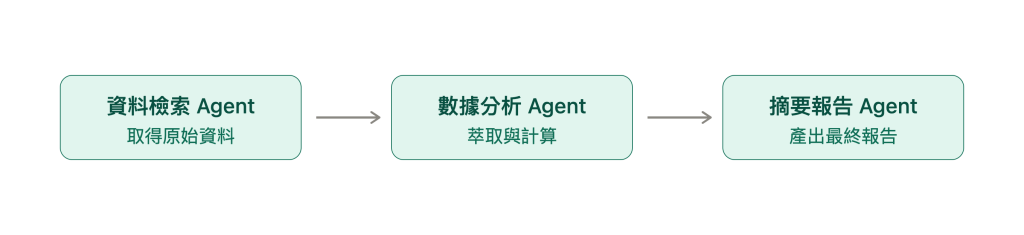
管線模式將任務拆解為固定順序的多個步驟,每個步驟由專屬 Agent 負責,上游 Agent 的輸出直接作為下游 Agent 的輸入(例如:資料檢索 Agent → 數據分析 Agent → 摘要報告 Agent)。
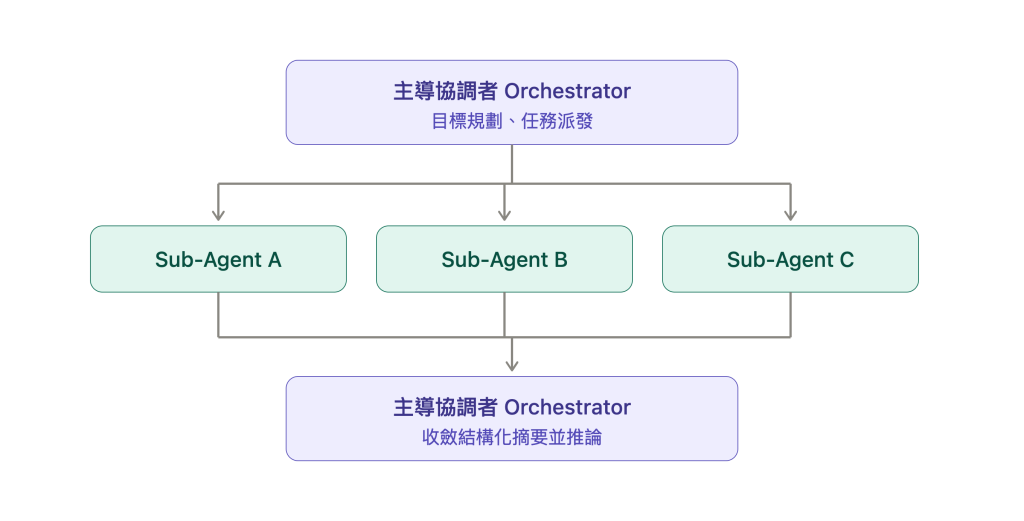
在需要高確定性、可觀測與狀態可控的正式環境中,協調者—子代理模式是最推薦的架構。由單一協調者動態規劃任務,子代理各自獨立執行並回報結構化結果:
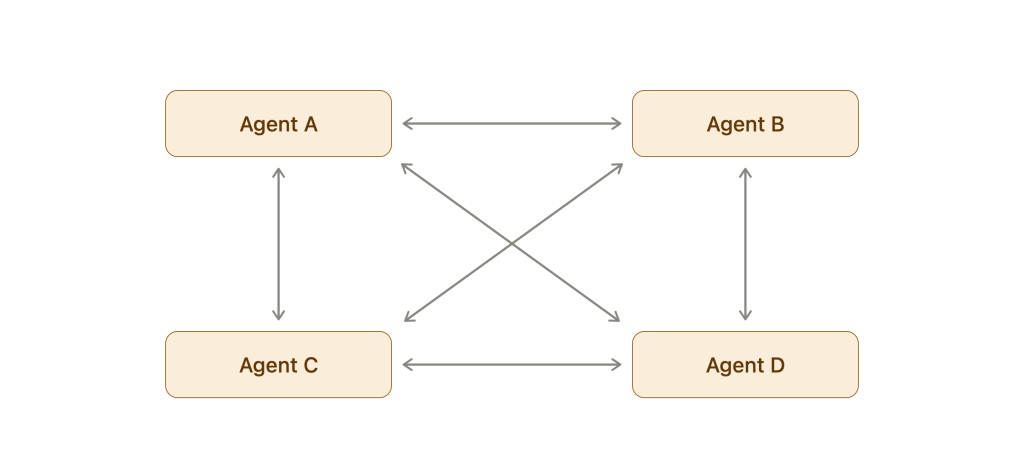
在去中心化模式中,系統沒有單一的主導協調者,多個 Agent 處於平級地位。Agent 之間透過自然語言或共享訊息匯流排自由對話,並自主決定何時將任務交接(Handoff)給下一個 Agent。
因此,在講求可維護性、確定性與成本控制的正式環境中,多數系統會優先選擇以 Orchestrator 作為核心調度中心,集中管控 Sub-Agent 的生命週期與資料交接。
Multi-Agent 系統的穩定性取決於 Agent 之間的交接契約(Contract)。Agent 之間不應傳遞隨意的自然語言長文,而應使用具備型別約束的結構化資料。協作契約通常包含「下發任務」與「回報結果」雙向規範:
Orchestrator 派工時不能只傳遞模糊的自然語言提示(例如「幫我排查系統異常」),否則 Sub-Agent 容易漫無目的地呼叫工具或偏離主題。Orchestrator 應傳遞邊界明確的任務規格:
from pydantic import BaseModel, Field


class SubTaskAssignment(BaseModel):
    """Orchestrator 派發給 Sub-Agent 的任務契約。"""
    task_id: str = Field(description="子任務識別碼,用於關聯追蹤")
    target_agent: str = Field(description="負責執行的專責 Agent 名稱,如 log_agent 或 metric_agent")
    goal: str = Field(description="單一且具體的執行目標,不包含模糊的多重指令")
    parameters: dict[str, str] = Field(
        default_factory=dict,
        description="執行所需的精確約束(如 service='checkout', time_range='10:00-10:15')"
    )
    context_artifact_ids: list[str] = Field(
        default_factory=list,
        description="前置步驟產出的大型資料 ID 參照,避免直接倒入長文字"
    )
parameters 鎖定排查的服務、時間區間或日誌等級,避免 Sub-Agent 撈取非必要的全量資料。context_artifact_ids,由 Sub-Agent 視需要主動調閱,防止主 Prompt 膨脹。Sub-Agent 完成任務後,只將推論所需的最小事實集合回傳給 Orchestrator:
class SubTaskResult(BaseModel):
    """Sub-Agent 交回給 Orchestrator 的結果契約。"""
    task_id: str = Field(description="對應的子任務識別碼")
    status: str = Field(description="執行狀態:success 或 failed")
    key_findings: list[str] = Field(description="萃取出的核心事實(控制在 3-5 條以內)")
    artifact_id: str | None = Field(default=None, description="若有大型原始資料,以 ID 參照存放於外部儲存")
key_findings 只保留主任務推論所需的關鍵結論(50~100 Tokens)。artifact_id,嚴禁將數萬字原始資料直接貼進回傳訊息。Multi-Agent 用獨立的 Context、工具集與權限,解決單一 Agent 的 Context 污染、工具過載、行為衝突與權限混用。拆分後,Orchestrator 集中調度 Sub-Agent,型別化的任務與結果契約約束 Agent 之間的交接,每個 Agent 只處理自己範圍內的資料與工具。
任務確實遇到上述問題時,才需要改用 Multi-Agent。單純步驟多或工具多時,單一 Agent 可以依序呼叫多個工具,在同一個 Context 內規劃、觀察結果並自主修正。每多一個 Agent,就要付出下列成本:
因此先優化 System Prompt、精簡 Tool 定義並提供明確的範例,確認單一 Agent 是否能完成任務;單一 Agent 確實遇到上述問題,再切分出 Sub-Agent。
下一篇將以 SRE 事故診斷系統為例,在 LangGraph 中完整實作 Orchestrator-Subagent 架構。


 iThome鐵人賽
 看影片追技術